最近学习了一些嵌入式相关知识,包括 STM32、FreeRTOS 等,也看到不少 AI 桌面机器人项目。相比直接购买成品,我更想亲手完成从硬件组装、固件修改到云端服务部署的完整过程,于是选择复刻一台桌面机器人,并在此基础上继续开发自己的功能。
硬件复刻
项目地址:https://oshwhub.com/movecall/moji2
硬件采用嘉立创开源平台上的 Moji 2.0 方案。
Moji 2.0 桌面 AI 机器人采用 ESP32-C5 主控和 1.5 寸圆形视网膜屏,屏幕通过连接器安装,支持自定义表情,并具备双频 Wi-Fi 6 连接能力。
打板与贴片
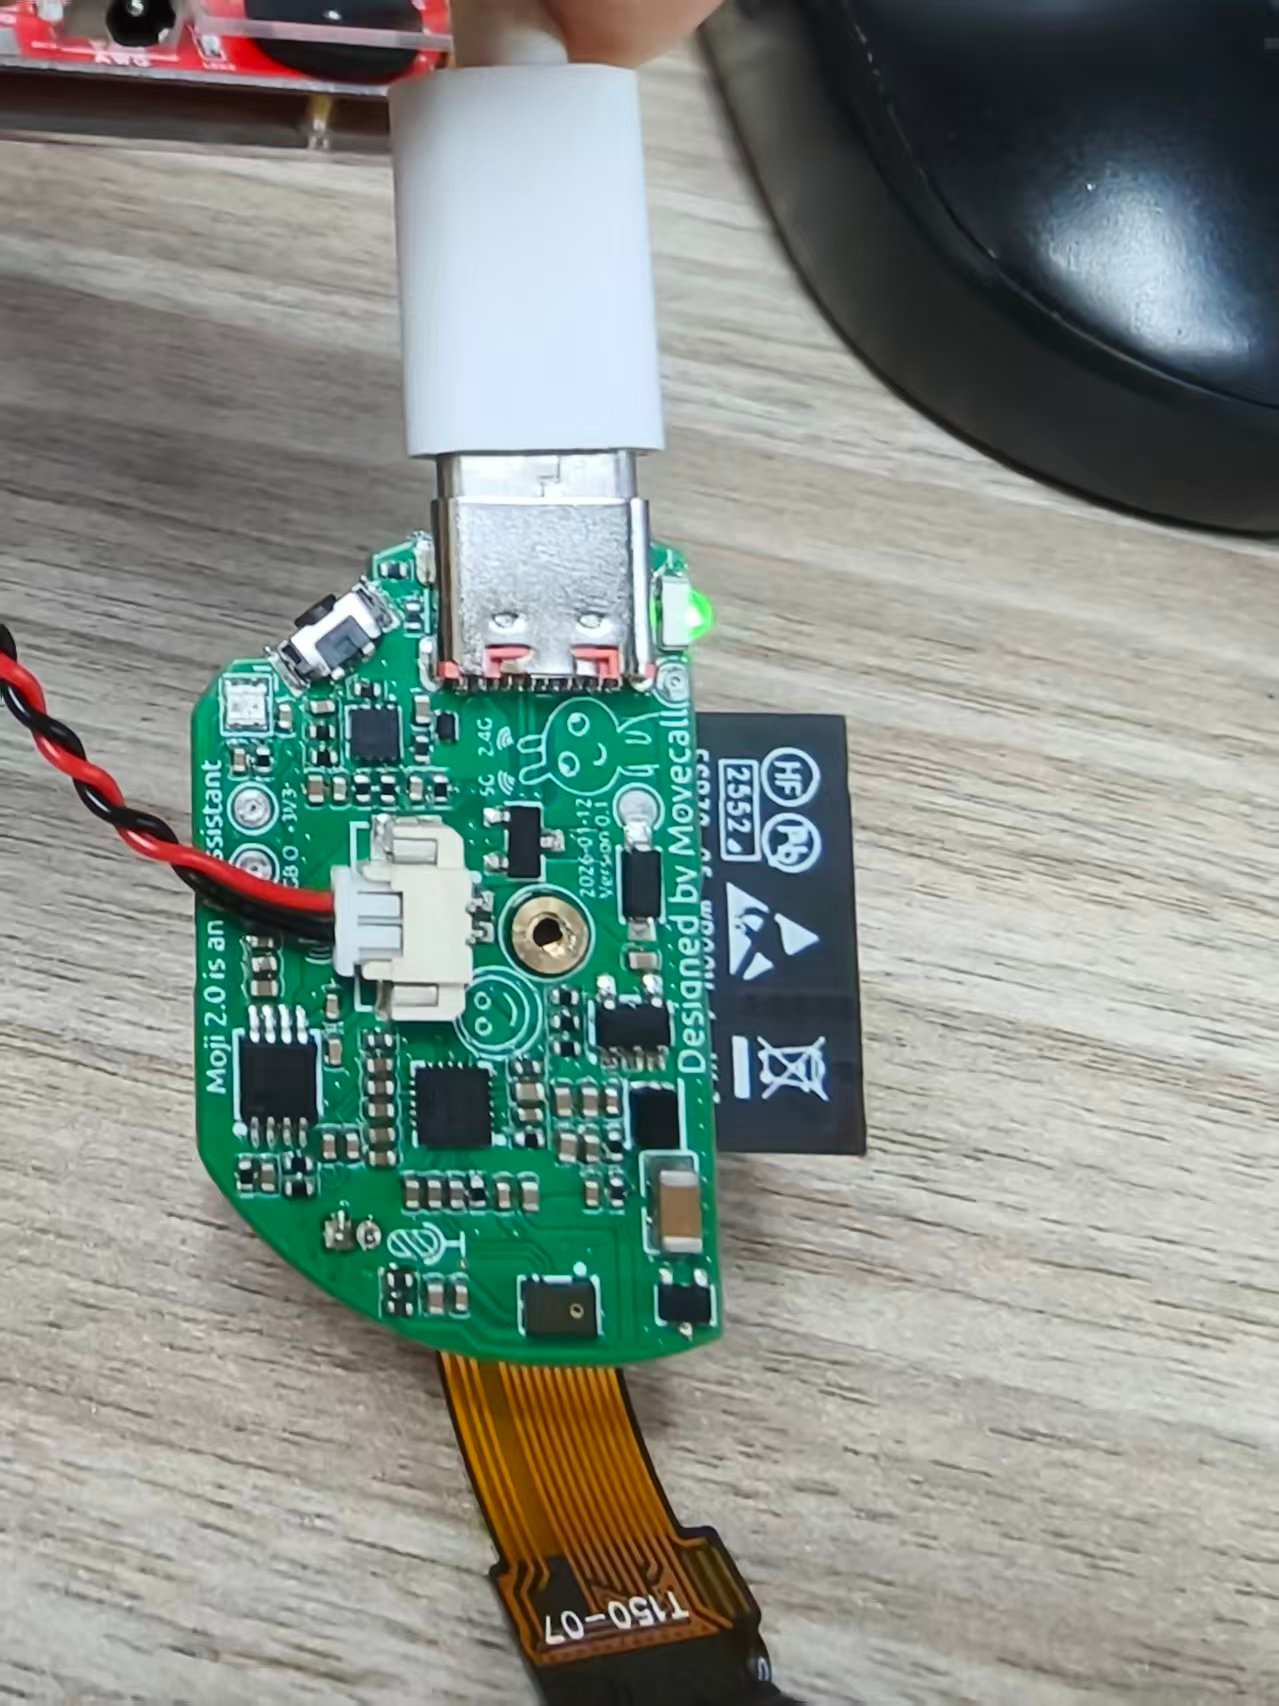
组装与测试
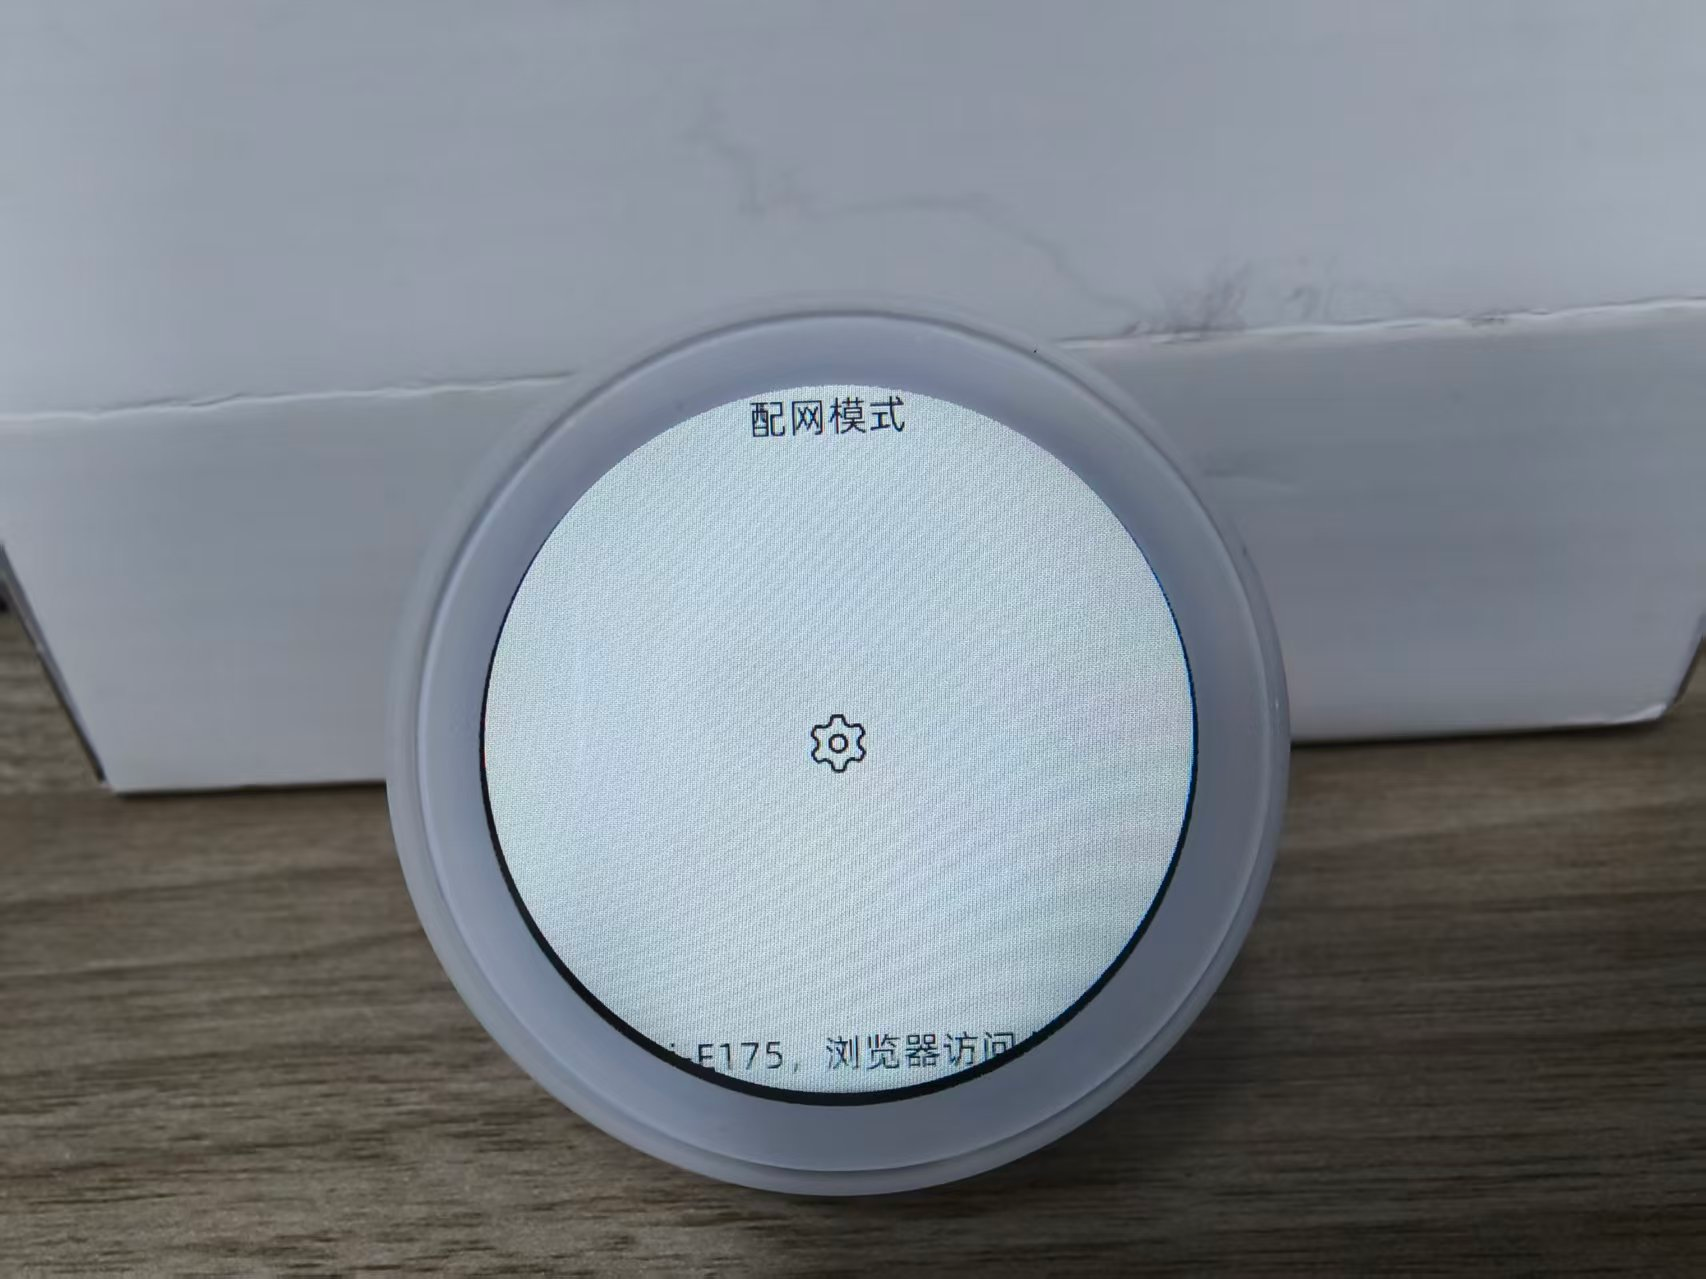
项目演示
目前的真机运行效果已经录制为视频,包含语音交互和部分功能展示:
最初想实现的功能
- 番茄钟
- 闹钟与提醒
- 多轮语音对话
- 待办事项与喝水提醒
真正开始开发后,我发现难点并不只是给界面增加几个页面。语音从麦克风上传到服务器,再经过识别、模型回答、语音合成并回到扬声器,中间涉及设备协议、音频格式、网络状态和多个云服务。要让机器人不仅能聊天,还能可靠地执行任务,需要同时改造设备端和服务端。
从语音问答到个人语音 Agent
我希望自己能够控制模型选择、调用额度和功能扩展,而不是只能使用固定的语音服务。因此,我在个人云服务器上搭建了 AI 网关,设备仍然负责唤醒、录音、播放和界面显示,服务器负责会话管理以及 AI 能力编排。
当前链路可以概括为:
1 | 本地唤醒词 |
AI 网关通过 Nginx 提供 HTTPS/WSS 入口,并使用设备令牌完成连接鉴权。当前 ASR、LLM 和 TTS 使用 DashScope 提供的模型服务,模型名称、音色和调用限制都可以通过服务端配置切换。因此,这个项目的“自建后端”主要指协议接入、对话编排、工具执行、状态管理和设备控制由自己掌握,并不代表模型本身运行在这台轻量服务器上。
流式语音对话
最初的实现需要等待大模型生成完整答案,再对整段文字进行语音合成。回答稍长时,用户说完话后会有比较明显的空白等待。
为降低等待时间,我将回答过程改为流式生成,并按照中文标点把增量文本切分成适合播报的短句。第一句话生成后就立即送入 TTS,后续句子继续在后台生成,从而实现“边生成、边合成、边播放”。
设备端使用 VAD 判断一轮说话何时结束,服务器保留有限轮数的上下文,使一次唤醒后可以继续追问。播放过程中再次说出唤醒词,会向网关发送中断事件,停止当前音频并重新进入聆听状态,避免只能等机器人把整段回答说完。
Function Calling 与工具执行
如果语音助手只能回答问题,很多日常功能仍然停留在“说完就结束”。因此,我实现了一个通用 Function Calling 框架,将工具的注册、参数描述、参数校验、调用执行和结果回传统一起来。模型只负责判断用户意图和选择工具,具体操作由网关中受控的函数完成。
目前接入了 14 个工具,主要分为以下几类:
- 实时信息:当前时间、当前位置、天气和服务器状态;
- 专注管理:创建、查询、暂停、继续或取消番茄钟;
- 任务管理:创建、查询、完成和删除待办事项;
- 提醒能力:创建、查询和取消闹钟或提醒;
- 每日简报:汇总当天的天气、未完成待办和提醒。
例如询问“今天天气怎么样”时,网关会根据设备请求的公网 IP 获取城市级位置,再调用 Open-Meteo 查询天气;询问服务器状态时,设备会进入状态大屏,持续展示 CPU、磁盘以及网络收发速率。工具返回的数据还可以通过设备事件直接驱动界面,而不只是让模型把结果念出来。
位置判断使用的是公网 IP,只能得到城市级的近似位置,不会获得 GPS 级精确坐标。公网 IP 仅在当前请求上下文中用于位置和天气查询,不写入对话历史。
任务持久化与离线提醒
待办和提醒数据保存在服务端 SQLite 中,便于语音创建、查询和汇总。但如果所有定时任务都只保存在云端,设备断网时就无法按时提醒。
为解决这个问题,网关在创建带时间的待办或提醒后,同时向 ESP32 下发调度命令。设备使用 NVS 保存最多 16 条本地提醒,到点后即使暂时无法连接服务器,也能显示提醒页面并播放提示音。提醒被取消、待办被完成或删除时,服务端也会同步取消设备上的本地任务。
这套设计并不是简单复制两份数据:SQLite 负责长期任务管理和每日简报,NVS 只保留设备必须独立执行的定时信息,两端各自承担更适合自己的职责。
圆形屏幕界面
这块设备使用 1.5 寸圆形屏幕,实际扫描 I²C 总线后没有发现可用的触摸控制器,因此交互仍以语音和唤醒词为主。界面设计也需要考虑圆形屏幕四角不可见、有效区域较小的问题。
目前使用 LVGL 完成了几类页面:
- 待机表盘:以时间为视觉中心,显示日期、电量、中文城市、天气、温度和湿度;
- 对话页面:统一为深色背景,并根据思考、回答等状态切换较大的表情;
- 番茄钟页面:突出显示倒计时,支持开始、暂停、继续、查询和取消;
- 服务器状态页:动态绘制 CPU、磁盘、RX 和 TX 曲线,并根据数据波动自动调整纵轴范围;
- 提醒页面:显示提醒类型、触发时间和事项内容,同时播放提示音。
其中 RX 表示服务器接收数据的速率,TX 表示服务器发送数据的速率。状态页面为两条曲线使用不同颜色,并在右上角图例中保持一致,便于在小屏幕上快速区分。
待机页面的天气不会频繁调用大模型。当前固件已经加入每 30 分钟一次的独立刷新逻辑,刷新时只请求网关的轻量天气接口,不消耗 ASR、LLM 或 TTS 额度;如果请求失败,设备会保留上一次有效天气,而不是把页面替换成空值。该固件已经完成编译和真机烧录,服务端刷新接口仍待同步部署后才能形成完整闭环。
服务运行与费用保护
服务部署在个人轻量应用服务器上,通过 systemd 管理进程。考虑到个人项目不需要生产级集群,但需要避免程序异常或调用失控,我增加了以下保护:
- 限制单设备并发会话、每分钟对话次数和每日总调用次数;
- 为 ASR、LLM 和 TTS 分别设置超时、有限重试和并发上限;
- 限制单轮输入时长、回答长度、单会话时长和最大对话轮数;
- 记录每日用量,但不保存原始音频和完整对话内容;
- 当每日调用量达到 80%、95% 和 100% 时,通过 QQ 邮箱发送告警;
- 配置服务健康检查、内存上限和异常自动重启。
天气和 IP 定位分别使用 Open-Meteo 与 IPWhois 的免费接口。单台设备每半小时刷新一次天气,理论上约为每天 48 次天气请求;城市定位有缓存,不会在每次表盘刷新时重复查询。它们不会消耗 DashScope 的模型额度,但仍需要遵守第三方服务的免费调用限制和署名要求。
开发过程中遇到的问题
这次开发中,最耗时间的并不是某一个页面,而是端云联调中的细节:
- 设备启动时曾在扫描 Wi-Fi、检查版本和连接服务器之间循环。最终通过检查 PSRAM 配置和串口日志定位问题,使设备能够稳定进入系统。
- 语音链路连接成功但没有声音时,需要逐段验证 WebSocket 握手、Opus 数据、采样率、TTS 输出和设备端 I²S 播放,而不能只看“服务器已连接”。
- 多轮对话和播放打断会同时操作 WebSocket。如果接收和播放互相阻塞,唤醒词虽然被检测到,扬声器仍不会立即停止。最终将接收循环与音频发送解耦,并使用中断事件终止当前播放。
- 云端提醒实现简单,但不能解决断网场景。将必要的调度能力下沉到设备并写入 NVS 后,提醒才真正具备可用性。
- 圆形屏幕的可视区域比矩形分辨率更受限,城市、电量和湿度文字都需要向中心收缩,图表纵轴也要根据实时数据动态缩放。
这些问题让我逐渐把项目从“功能能跑”推进到“交互闭环能够稳定使用”。
当前完成情况
目前已经完成硬件组装、ESP32-C5 固件修改、个人 AI 网关部署和端云真机联调。机器人可以进行流式多轮语音对话,通过唤醒词打断回答,并使用自然语言查询实时信息、控制番茄钟、管理待办和创建提醒;待机表盘、对话表情、服务器监控和任务提醒也都能在圆形屏幕上进行对应展示。
项目仍有继续优化的空间。例如,半小时天气刷新接口需要部署到服务器,模型免费额度耗尽时还可以增加自动降级策略,提醒也可以扩展为周期任务。后续我还计划整理部署脚本和配置说明,让固件、网关和第三方模型配置更容易复现。
从最初复刻一块开源硬件,到后来自己设计语音链路、工具框架和任务调度,这个项目让我完整经历了嵌入式设备、实时音频、后端服务和 AI 应用编排之间的协作过程。对我来说,它已经不只是一个“会聊天的桌面摆件”,而是一台可以继续扩展的个人语音 Agent。